Googleが発表した第8世代TPUは、これからのAIインフラのあり方を根本から覆す可能性を秘めた革新的なプロセッサです。本記事では、この最新アーキテクチャである学習特化型の「TPU 8t」と、推論特化型の「TPU 8i」について、それぞれの役割や技術的特徴を詳しく解説します。
エージェンティックAIが急速に普及する現代において、AIモデルの高度化に伴う計算資源の不足や遅延の課題を、第8世代TPUがどのように解決に導くのでしょうか。第6世代「Trillium」や第7世代「Ironwood」といった歴代モデルからの進化の軌跡を紐解きながら、企業のAI開発にもたらす具体的なメリットや、今後のGoogle Cloudにおける展開について網羅的に紹介しています。
第8世代TPUとはGoogle製の最新式AI特化型プロセッサ
第8世代TPU(Tensor Processing Unit)は、Googleが自社開発するAI特化型プロセッサの最新モデルです。AI技術が急速に進化し、あらゆる産業で社会実装が進むなかで、Googleはなぜこのタイミングで新しいアーキテクチャを投入したのでしょうか。その基本概要と発表に至った背景を詳しく見ていきましょう。
Google Cloud Next ‘26での発表
第8世代TPUは、世界中の開発者が注目するイベント「Google Cloud Next ‘26」にてベールを脱いだ、次世代のAIアクセラレータです。
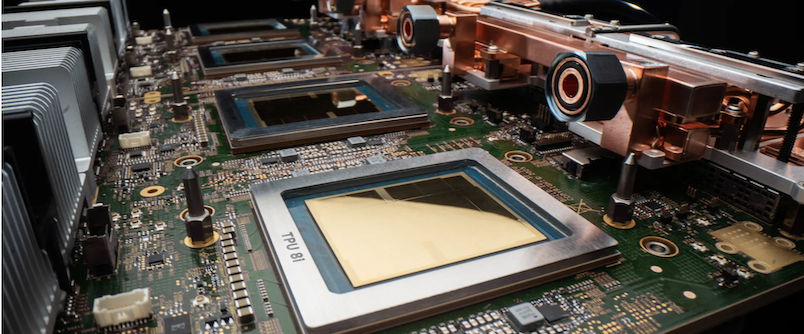 出典:第8世代TPU:エージェンティック時代に向けた2つのチップ|Google Cloud
単一のチップデザインでモデルの学習と推論の両方をカバーしていた従来のアプローチから完全に脱却し、学習用と推論用にチップの設計を根本から分離した点が、最大のトピックとして大きな注目を集めました。基調講演では、急激に肥大化する大規模言語モデル(LLM)などの計算需要に応えるため、従来の延長線上ではないアーキテクチャの刷新が必要であったことが熱く語られています。
この第8世代TPUの投入により、GoogleはクラウドAIインフラ市場における自社の優位性をさらに確固たるものにしようとしています。特に、ハードウェアレベルでの徹底した最適化により、競合他社の汎用GPUプラットフォームと比較して、卓越したコストパフォーマンスと電力効率を実現できる点が強みです。
エージェンティックAI時代への対応
この革新的なプロセッサが誕生した背景には、エージェンティックAIの本格的な普及という大きな波があります。
従来のユーザーのプロンプトに対して単一の応答を返す受動的なAIとは異なり、エージェンティックAIは自律的に計画を立て、複数の外部ツールやAPIを駆使しながら複雑なタスクを連続的に実行します。そのため、推論プロセスにおいて膨大なコンテキスト(文脈)を瞬時に処理し、絶え間なくシステム間で通信する能力が求められます。
第8世代TPUは、こうした複雑で連続的な処理を、ユーザーにストレスを感じさせない無遅延で実行できるように設計されました。メモリ帯域幅の大幅な拡張や、チップ間の通信速度の劇的な向上により、エージェンティックAIが求める極めて厳格なパフォーマンス要件をクリアしています。次世代の高度なAIアプリケーションが現実社会で実用化されるための、まさに強固な基盤となるハードウェアです。
用途に合わせたアーキテクチャの分離
第8世代TPUにおける最大のパラダイムシフトは、学習専用の「TPU 8t(Training)」と、推論専用の「TPU 8i(Inference)」へとアーキテクチャが完全に分離されたことです。
これまでのAI開発現場では、モデルの学習と推論で求められるコンピューティングリソースの特性が大きく異なるにもかかわらず、汎用的なチップが使われがちでした。学習フェーズには、PB(ペタバイト)級のデータを並列処理するための巨大な演算能力と超広帯域のネットワークが必要です。一方で推論フェーズには、ユーザーからのリクエストをいかに低遅延かつ省電力で処理するかが問われます。
Googleはこれらの相反するニーズに妥協なく応えるため、物理的に異なる設計思想を持つ2つのチップを生み出しました。これにより、各フェーズにおけるリソースの無駄を徹底的に排除し、限界までパフォーマンスを引き出せるようになります。
第8世代TPUを象徴する4つの特徴
第8世代TPUには、次のような特徴があります。
- TPU 8tのネットワークトポロジ「Virgo」と超大規模分散処理
- TPU 8iの「Boardfly」トポロジによる低遅延通信の実現
- TPU 8tとTPU 8iを支える「Axion」との連携
- JAXやPyTorchをはじめとするソフトウェア互換性
それぞれの特徴について詳しく解説します。
TPU 8tのネットワークトポロジ「Virgo」と超大規模分散処理
超巨大なモデルを学習させるTPU 8tにおいて、最も重要な技術的進化の一つが新開発のネットワークトポロジ「Virgo(ヴァルゴ)」です。数十万個のチップを相互接続して分散学習を行う際、従来のトーラス構造やツリー構造のネットワークでは、データ転送の渋滞が学習速度の足を引っ張ってしまいます。
Virgoトポロジは、最先端の光通信技術を駆使した多次元のメッシュ構造を採用しており、あらゆるチップ間で極めて広帯域かつ最短距離の通信経路を動的に確保します。これにより、ノード間で膨大なパラメータを同期する際の遅延が実質的にゼロに近付き、並列化の効率が理論上の限界値にまで引き上げられます。モデル分割におけるオーバーヘッド(間接的な負荷)が激減するため、これまで不可能と思われていた超大規模分散学習を、極めて安定して実行できるようになります。
TPU 8iの「Boardfly」トポロジによる低遅延通信の実現
推論特化のTPU 8iには、「Boardfly(ボードフライ)」と呼ばれる、Virgoとはまったく異なるアプローチのネットワークトポロジが採用されています。
推論タスクにおいては、数万個規模の大規模なクラスタリングよりも、数十から数百個のチップ間での超低遅延なデータ共有が極めて重要になります。例えば、巨大なLLMを複数の推論チップに分割して配置し、推論を実行する場合、チップ間でトークン情報を瞬時に受け渡す必要があります。
Boardflyは、ラック内のチップ同士を極限まで短いレイテンシで直結する特殊なルーティング技術を用いており、推論時のチップ間通信のオーバーヘッドをナノ秒単位にまで削減します。これにより、ユーザーが体感する応答速度が大幅に向上し、より自然で人間らしいスピードで対話する次世代のAIアプリケーションの構築が可能になります。
TPU 8tとTPU 8iを支える「Axion」との連携
第8世代TPUのポテンシャルをシステムレベルで最大限に引き出すのが、Googleが独自開発したArmベースのデータセンター向けCPU「Axion」との密接な連携です。
AIのワークロードには、TPUが行う行列演算だけでなく、データの前処理やネットワークトラフィックの制御、ストレージの入出力管理など、ホスト側で行うべき周辺タスクが多々存在します。Axionはこれらのタスクを極めて高い電力効率で処理し、TPUを管理するホストCPUとしての役割を完璧にこなします。
第8世代TPUとAxionは、Google Cloudのインフラストラクチャ上で統合的に動作するようにハードウェアレベルで最適化されており、システム全体のボトルネックを解消します。データの受け渡しにかかるオーバーヘッドが激減することで、AIモデルの学習から推論に至る一連のパイプラインをスムーズに進行できるのがメリットです。
JAXやPyTorchをはじめとするソフトウェア互換性
どれほどハードウェアのスペックが優れていても、ソフトウェアの強力なサポートがなければその力は発揮できません。第8世代TPUは、主要なAIフレームワークとのソフトウェア互換性を過去最高レベルで高めています。Googleが自社で主導する「JAX」はもちろんのこと、世界中の研究者や開発者の間で広く使われている「PyTorch」に対しても完全なネイティブサポートを提供しており、開発者は使い慣れたコードベースのままTPUの圧倒的な計算能力を利用できます。
さらに、大規模言語モデルの高効率な推論エンジンとしてデファクトスタンダードとなりつつある「vLLM」をはじめ、強力なオープンソースツールにも正式に対応しました。これにより、既存の学習済みモデルや推論システムを最小限の修正で第8世代TPU環境に移行できるようになり、企業が最新インフラを導入する際のハードルが劇的に下がりつつあります。
歴代TPU(第6世代・第7世代)からの進化と性能比較
AIの進化のスピードに歩調を合わせるように、TPUも急速な世代交代を遂げてきました。ここでは、数年前の最先端であった第6世代「Trillium」や、直近のモデルである第7世代「Ironwood」と比較しながら、第8世代TPUがどれほどの飛躍を遂げたのかを解説します。
第6世代(Trillium)からのアーキテクチャの変遷
2024年に発表された第6世代「Trillium(トリリウム)」は、当時としては革新的な演算性能を誇り、特にスパース(まばら)なモデルの処理などに強みを持っていました。しかし、Trilliumの時点では、あくまで単一のチップ設計で学習と推論の両方のバランスを取るという、汎用的な設計思想にとどまっていました。そこからわずか数年、生成AIモデルのパラメータ数と複雑さが指数関数的に増大するなかで、アーキテクチャの抜本的な見直しが迫られたのです。
第8世代TPUは、Trilliumの時代から培ってきた行列演算の高効率化技術をしっかりと継承しつつも、「学習」と「推論」でシリコンダイを完全に分離したことで、チップ面積の利用効率が格段に向上しています。単にトランジスタの集積度を高めるだけでなく、「何に使うチップか」を明確に定義し直したことが、Trilliumからの最も大きな進化だといえます。
第7世代(Ironwood)との学習性能の比較
前世代にあたる第7世代「Ironwood(アイアンウッド)」と比較すると、学習専用となった「TPU 8t」の性能向上は目覚ましいものがあります。
| 比較項目 | Ironwood | TPU 8t |
| ポッドサイズ | 9,216 | 9,600 |
| ポッドあたりのFP4 EFlops | 42.5 | 121 |
| 双方向スケールアップ帯域幅 (1チップあたりTB/s) |
9.6 | 19.2 |
| スケールアウトネットワーク帯域幅 (1チップあたりGB/s) |
100 | 400 |
Googleの公式発表によれば、同一規模の大規模言語モデル(LLM)の学習ワークロードにおいて、TPU 8tはIronwoodに対してチップ単体で約2.5倍のFLOPS(浮動小数点演算性能)を発揮します。さらに重要なのがメモリ帯域幅の劇的な拡張で、次世代の広帯域メモリ技術を採用したことにより、データ転送速度がIronwoodの約3倍に跳ね上がりました。
これに新開発のVirgoトポロジによるネットワークの最適化が加わることで、数万チップを用いたクラスタ全体での実効性能は、Ironwood比で4倍以上に達するとされています。これは、これまで数ヶ月を要していた数兆パラメータモデルのトレーニングが、わずか数週間で完了することを意味しています。
第7世代(Ironwood)との推論パフォーマンスの比較
推論性能においても、第7世代からのパフォーマンスの向上は圧倒的です。
| 比較項目 | Ironwood | TPU 8i |
| ポッドサイズ | 256 | 1,152 |
| ポッドあたりのFP8 EFlops | 1.2 | 11.6 |
| ポッドあたりの総HBM容量(TB) | 49.2 | 331.8 |
| 双方向スケールアップ帯域幅 (1チップあたりTB/s) |
9.6 | 19.2 |
推論特化の「TPU 8i」は、Ironwoodと比較して1秒間に処理できるトークン数(スループット)が最大で3.5倍に向上しています。これはオンチップSRAM容量の倍増と、低レイテンシに特化して演算器のパイプラインを再設計したチューニングによる成果です。
さらに、コスト効率(TCO)が大幅に改善された点も見逃せません。TPU 8iは消費電力あたりの推論性能が極めて高く、データセンターの電力制限や環境負荷への配慮が厳格化する現代において、運用コストを大幅に押し下げる効果を発揮します。同じ推論リクエスト量を処理する場合、Ironwood環境と比較してインフラコストを半減させることも可能です。
第8世代TPUがAI開発にもたらす3つのメリット
第8世代TPUの登場は、単にハードウェアのカタログスペックが上がったという事実にとどまりません。実際のAI開発プロジェクトや企業のビジネスにどのようなインパクトを与えるのか、開発現場の視点から、第8世代TPUを導入することで得られるメリットを解説します。
大規模基盤モデルの事前学習期間の大幅な短縮
独自の基盤モデルをゼロから開発する際、最大のネックとなるのが、膨大な時間と計算リソースを消費する事前学習フェーズです。数千から数万個のGPUやTPUを数ヶ月間フル稼働させる必要があり、一度の試行錯誤にかかる金銭的・時間的コストも莫大な規模に達します。
その点、TPU 8tの圧倒的な並列処理能力とスループットは、この事前学習期間を劇的に短縮することが可能です。数ヶ月かかっていた学習が数週間に、数週間かかっていたものが数日に短縮されることで、研究者はより多くの仮説を検証し、モデルのアーキテクチャや学習データのチューニングを迅速に行えるようになるでしょう。このアジリティ(俊敏性)の向上は、競争が激化するAI開発レースにおいて、他社に先駆けて高品質な独自モデルを市場に投入するための強力な武器となります。
リアルタイム推論におけるメモリの壁の打破と低遅延化
生成AIを実際のビジネスサービス(顧客対応チャットボットやコード自動生成、リアルタイム音声翻訳など)に組み込む際、ユーザー体験を決定付けるのが応答速度です。
TPU 8iは、大容量かつ高速なオンチップメモリと、超低遅延なネットワークトポロジ「Boardfly」の組み合わせにより、チップ業界で長年の課題であった「メモリの壁(Memory Wall)問題」の打破につながります。モデルの重みパラメータやユーザーのコンテキスト情報を高速に読み出せるため、ユーザーからの入力に対して瞬時にテキストや画像を生成し返すことができます。
特に、長大なコンテキストを保持しながら連続してタスクをこなすエージェンティックAIにおいては、この低遅延化が不可欠です。TPU 8iを活用することで、人間と対話しているのと遜色のない、スムーズでストレスのない交流が可能になります。
ベアメタルアクセスによる仮想化オーバーヘッドの排除
エンタープライズ環境で第8世代TPUを利用する大きな利点の一つが、Google Cloudが提供する「Cloud TPU ベアメタル」の強力なサポートを得られることです。
通常、クラウド上のコンピューティングリソースは仮想マシン(VM)を通じて提供されますが、この仮想化レイヤーはわずかながら通信遅延やオーバーヘッドを生み出します。特にミリ秒単位の極限の性能最適化が求められる最先端のAI開発においては、このわずかな遅延が積み重なって大きなボトルネックにもなりかねません。
第8世代TPUでは、ハードウェアに直接アクセスできるベアメタル環境が選択肢として提供されます。OSやハイパーバイザの介入を最小限に抑え、TPUが持つ素のパフォーマンスを100%引き出せる点が強みです。
第8世代TPUのその先は?今後の展開を予想
今回の第8世代TPUの発表は、Googleが全社を挙げて推進する「AI Hypercomputer構想」における、極めて重要なマイルストーンだといえます。この構想は、TPUやGPUといった計算リソースやオープンなソフトウェアフレームワーク、超高速な光ネットワーク、そして柔軟なデータストレージを統合し、データセンター全体をあたかも一つの巨大なAI専用スーパーコンピュータとして機能させるという壮大なビジョンです。
学習用と推論用にチップを分離し、システム全体を最適化した第8世代TPUのアーキテクチャは、このビジョンを完成させるための決定的なピースでした。Googleは今後もハードウェアとソフトウェアの協調設計を推し進め、消費エネルギーの効率を高めながら、限界なきパフォーマンスを追求していくでしょう。AI開発者にとって、インフラの制約を一切意識することなく、純粋にモデルの革新にのみ集中できる未来がすぐそこまで来ています。
総括:AIの進化を現実世界へ解き放つ第8世代TPUのインパクト
Google Cloud Next ‘26で発表された第8世代TPUは、学習専用の「TPU 8t」と推論専用の「TPU 8i」に分離されるという大胆なアーキテクチャの刷新により、AIインフラの新たな標準を打ち立てました。エージェンティックAIが求める途方もない計算量と、実サービスで必要となる厳しい低遅延の要件を同時にクリアし、歴代のTrilliumやIronwoodから飛躍的な性能向上とコスト効率の改善を実現しています。
開発者はTPU 8tによって、これまで膨大な時間がかかっていた基盤モデルの学習期間を大幅に短縮し、TPU 8iによってユーザーへ提供する推論サービスのレイテンシと運用コストを極限まで削ぎ落とすことが可能になります。物理AIや高度なロボティクスなど新たな領域への応用も含め、企業の次世代AIビジネスを加速させる最強のエンジンとなることは間違いないでしょう。
生成AIのビジネス活用や、セキュリティ・ガイドライン整備に不安を感じている場合は、3,000社以上の導入実績を持つ電算システムの「生成AI支援サービス」の導入をご検討ください。Gemini Enterpriseの環境構築から社内データ連携、運用保守まで、Google Cloudプレミアパートナーならではの技術力で徹底支援します。豊富な資料も用意していますので、ぜひ電算システムへと気軽にお問い合わせください。